Kod genetyczny – uniwersalny język życia. Cechy i znaczenie kodu genetycznego
Jak cztery rodzaje nukleotydów wystarczają do zapisania instrukcji budowy tysięcy różnych białek? Odpowiedź kryje się w kodzie genetycznym – uniwersalnym języku, którym posługują się niemal wszystkie organizmy. Sprawdź, czym są kodony, jak komórka odczytuje zapisaną w nich informację i dlaczego nawet niewielka zmiana sekwencji DNA może wpłynąć na budowę białka.
Informacja potrzebna do budowy białek jest zapisana w DNA za pomocą zaledwie czterech rodzajów nukleotydów. Komórka musi jednak wykorzystać tę informację do połączenia dwudziestu różnych aminokwasów w odpowiedniej kolejności. Jak czteroliterowy zapis zostaje przetłumaczony na język białek? Umożliwia to kod genetyczny – zestaw reguł określających, w jaki sposób sekwencja nukleotydów w mRNA wyznacza sekwencję aminokwasów w białku.
Czym jest kod genetyczny?
Kod genetyczny to sposób zapisu informacji o budowie białek w sekwencji nukleotydów DNA, a dokładniej – sposób odczytywania tej informacji na podstawie sekwencji mRNA.
Informacja genetyczna przepływa zgodnie ze schematem:
DNA → mRNA → białko
Najpierw podczas transkrypcji fragment informacji zapisanej w DNA zostaje przepisany na mRNA. Następnie w czasie translacji rybosom odczytuje sekwencję mRNA i na jej podstawie łączy aminokwasy w łańcuch polipeptydowy.
Można powiedzieć, że kod genetyczny pełni funkcję słownika, który pozwala tłumaczyć język nukleotydów na język aminokwasów.
Kodon – podstawowa jednostka kodu genetycznego
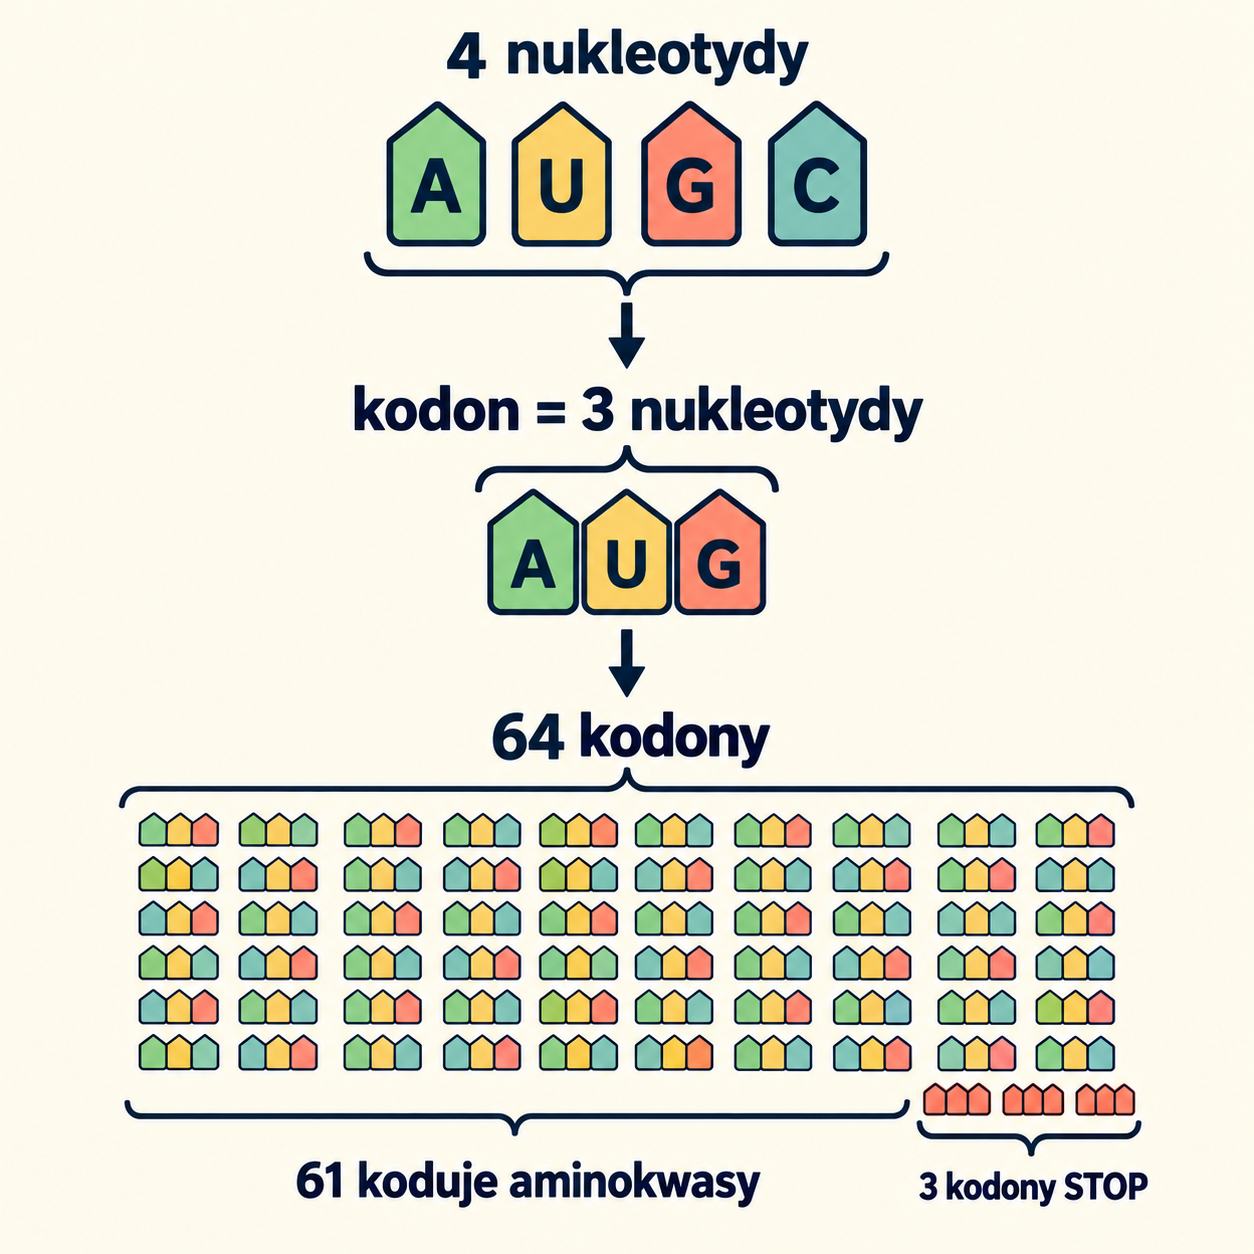
Rybosom nie odczytuje nukleotydów pojedynczo. Sekwencja mRNA jest dzielona na kolejne grupy po trzy nukleotydy. Każda taka trójka nazywana jest kodonem.
Przykładowa sekwencja mRNA może wyglądać następująco:
5′–AUG–GCU–AAA–UGA–3′
Zostaje ona odczytana jako cztery kolejne kodony:
- AUG,
- GCU,
- AAA,
- UGA.
Poszczególne kodony mają określone znaczenie:
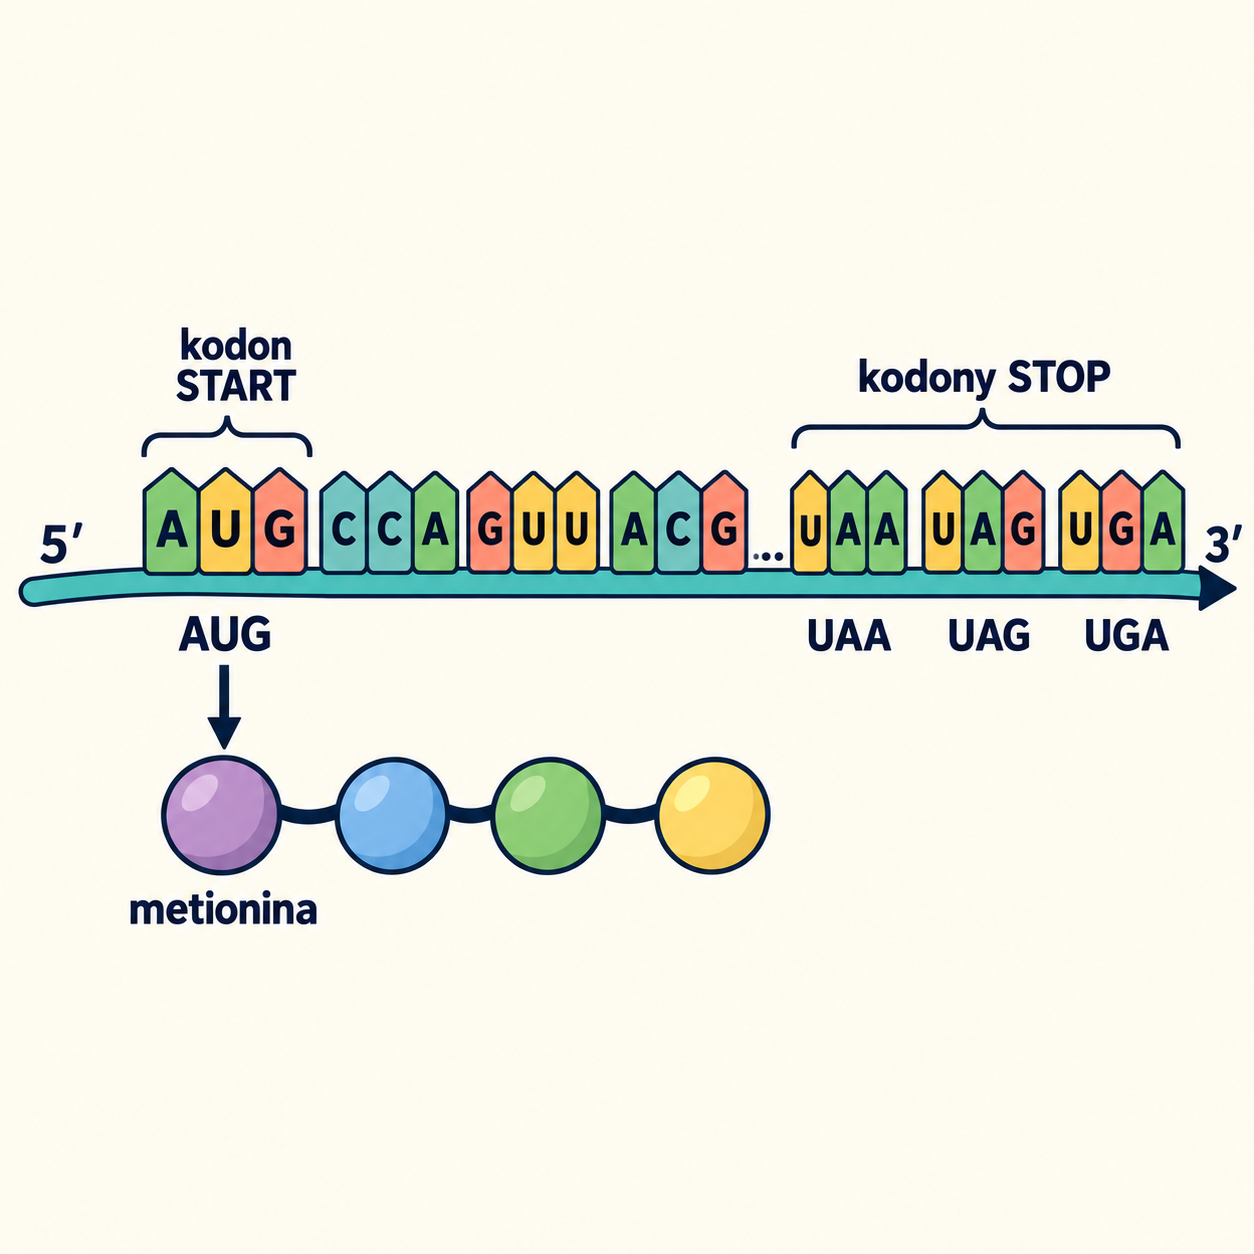
- AUG – kodon rozpoczynający translację, kodujący metioninę,
- GCU – kodon alaniny,
- AAA – kodon lizyny,
- UGA – jeden z kodonów kończących translację.
W wyniku odczytania tej sekwencji powstaje krótki łańcuch:
metionina – alanina – lizyna
Kodon UGA nie oznacza żadnego aminokwasu. Jest sygnałem zakończenia translacji.
Dlaczego kod genetyczny jest trójkowy?
W mRNA występują cztery rodzaje nukleotydów:
- adenina – A,
- uracyl – U,
- guanina – G,
- cytozyna – C.
Gdyby każdy aminokwas był kodowany przez jeden nukleotyd, możliwe byłyby tylko cztery kombinacje. Gdyby aminokwasom odpowiadały pary nukleotydów, liczba kombinacji wynosiłaby:
4² = 16
To nadal zbyt mało, aby zakodować dwadzieścia podstawowych aminokwasów.
Dopiero zestawienie nukleotydów w trójki daje:
4³ = 64 kodony
Taka liczba wystarcza do zakodowania wszystkich aminokwasów oraz sygnałów rozpoczynających i kończących translację.
Spośród 64 kodonów:
- 61 koduje aminokwasy,
- 3 pełnią funkcję kodonów STOP.
Kodon START
Kodonem rozpoczynającym translację jest najczęściej:
AUG
Kodon ten:
- wyznacza miejsce rozpoczęcia translacji,
- ustala prawidłową ramkę odczytu,
- koduje aminokwas metioninę.
U bakterii pierwszym aminokwasem w powstającym białku jest zmodyfikowana forma metioniny – N-formylometionina, oznaczana jako fMet. U eukariontów translacja rozpoczyna się od zwykłej metioniny.
AUG znajdujący się wewnątrz odczytywanej sekwencji również koduje metioninę. Jego funkcja zależy więc od położenia i kontekstu, w którym zostaje rozpoznany przez rybosom.
Kodony STOP
Zakończenie translacji wyznaczają trzy kodony:
- UAA,
- UAG,
- UGA.
Nie odpowiadają one żadnemu aminokwasowi i nie są rozpoznawane przez tRNA. Gdy kodon STOP znajdzie się w miejscu A rybosomu, przyłącza się do niego czynnik uwalniający. Powoduje to:
- odłączenie gotowego łańcucha polipeptydowego,
- zakończenie translacji,
- rozdzielenie podjednostek rybosomu.
Jak odczytywana jest informacja genetyczna?
Rybosom przesuwa się wzdłuż mRNA w kierunku:
od końca 5′ do końca 3′
Każdy kodon jest rozpoznawany przez odpowiednią cząsteczkę tRNA. Znajdujący się w tRNA antykodon łączy się z kodonem mRNA zgodnie z zasadą komplementarności.
Przykład:
- kodon mRNA: 5′–AUG–3′,
- antykodon tRNA: 3′–UAC–5′.
Kodon i antykodon są względem siebie komplementarne oraz antyrównoległe. Do drugiego końca tRNA przyłączony jest odpowiedni aminokwas. Dzięki temu tRNA działa jak pośrednik pomiędzy językiem nukleotydów a językiem aminokwasów.
Za prawidłowe połączenie tRNA z odpowiednim aminokwasem odpowiadają enzymy nazywane syntetazami aminoacylo-tRNA. Dokładność ich działania ma ogromne znaczenie dla poprawnego przebiegu translacji.
Najważniejsze cechy kodu genetycznego
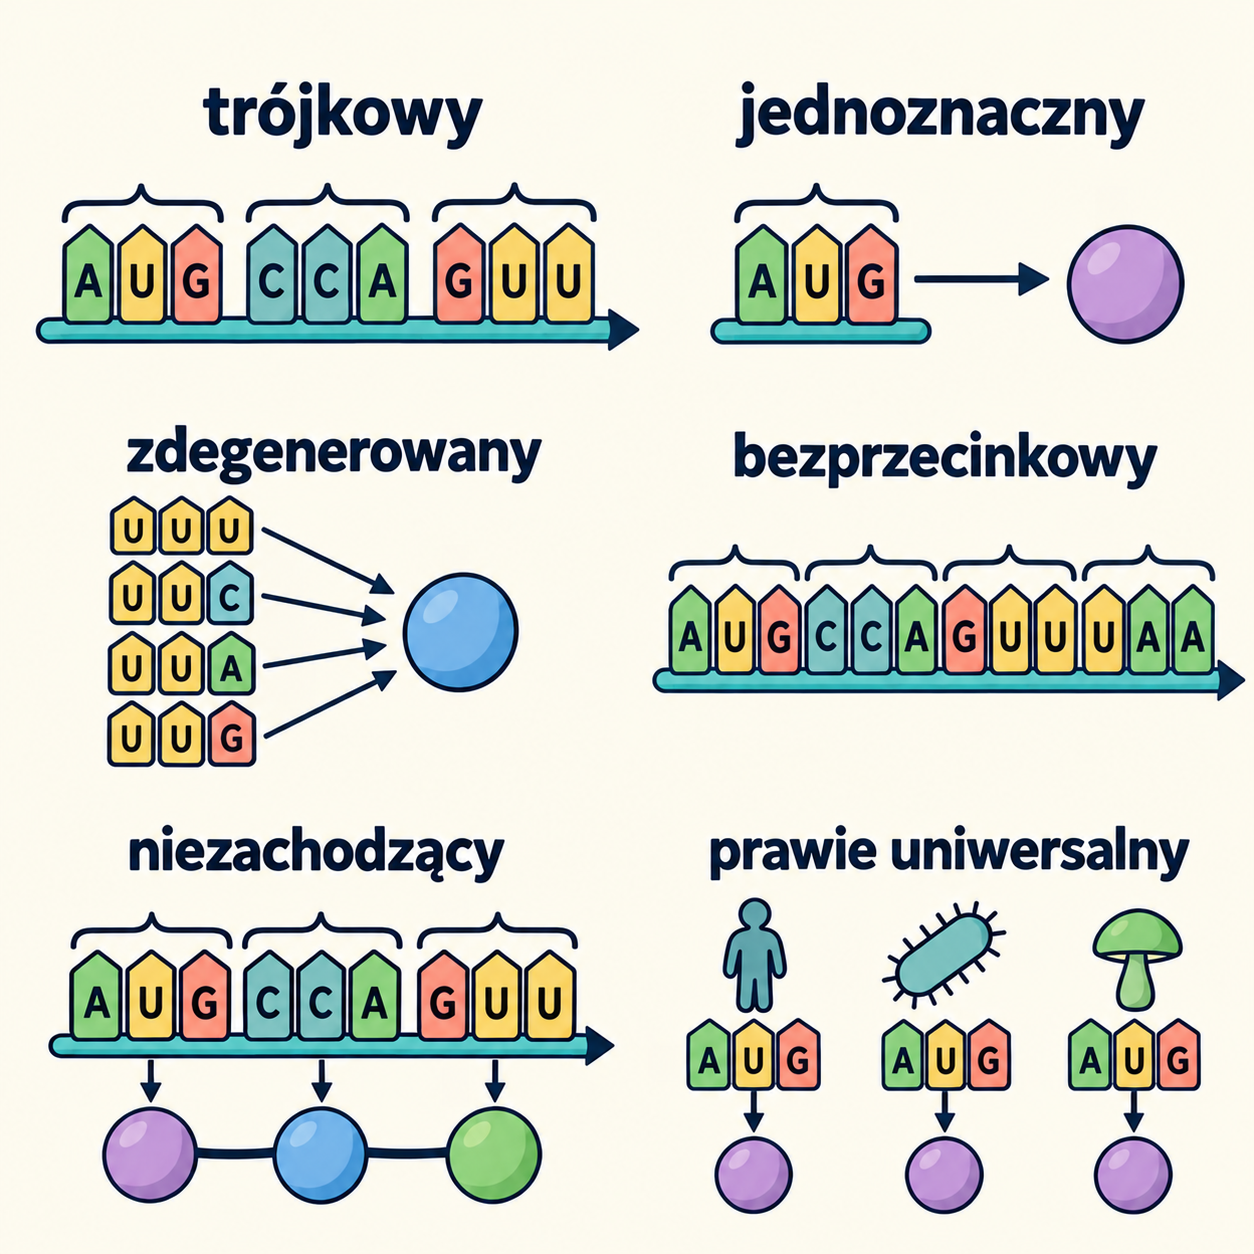
Kod genetyczny jest trójkowy
Każdy aminokwas jest określany przez układ trzech kolejnych nukleotydów mRNA, czyli jeden kodon.
Przykładowo:
- UUU koduje fenyloalaninę,
- GCU koduje alaninę,
- UGG koduje tryptofan.
Kod genetyczny jest jednoznaczny
Każdy kodon oznacza tylko jeden konkretny aminokwas albo sygnał zakończenia translacji.
Kodon UGG zawsze koduje tryptofan. Nie może w jednej sytuacji oznaczać tryptofanu, a w innej – zupełnie innego aminokwasu.
Jednoznaczność nie oznacza jednak, że każdy aminokwas ma tylko jeden kodon.
Kod genetyczny jest zdegenerowany
Większość aminokwasów może być kodowana przez więcej niż jeden kodon.
Przykładowo leucyna jest kodowana przez sześć kodonów:
- UUA,
- UUG,
- CUU,
- CUC,
- CUA,
- CUG.
Zdegenerowanie kodu wynika z tego, że istnieją 61 kodony kodujące, ale tylko 20 podstawowych aminokwasów.
Kodony oznaczające ten sam aminokwas często różnią się ostatnim nukleotydem. Taka budowa kodu może ograniczać skutki niektórych mutacji punktowych, ponieważ zmiana jednego nukleotydu nie zawsze powoduje zmianę aminokwasu.
Nie należy mylić dwóch cech kodu:
- jednoznaczność – jeden kodon oznacza tylko jeden aminokwas,
- zdegenerowanie – jeden aminokwas może być kodowany przez kilka różnych kodonów.
Kod genetyczny jest bezprzecinkowy
Pomiędzy kolejnymi kodonami nie występują żadne specjalne nukleotydy pełniące funkcję znaków oddzielających.
Sekwencja:
AUGGCUAAA
jest odczytywana jako:
AUG | GCU | AAA
Rybosom rozpoznaje kolejne trójki bez przerw i bez pomijania nukleotydów.
Kod genetyczny jest niezachodzący
W prawidłowo ustalonej ramce odczytu każdy nukleotyd należy tylko do jednego kodonu.
W sekwencji:
AUGGCUAAA
kodony są odczytywane następująco:
AUG | GCU | AAA
Nukleotyd należący do kodonu AUG nie jest jednocześnie wykorzystywany do tworzenia kolejnego kodonu.
Kod genetyczny jest prawie uniwersalny
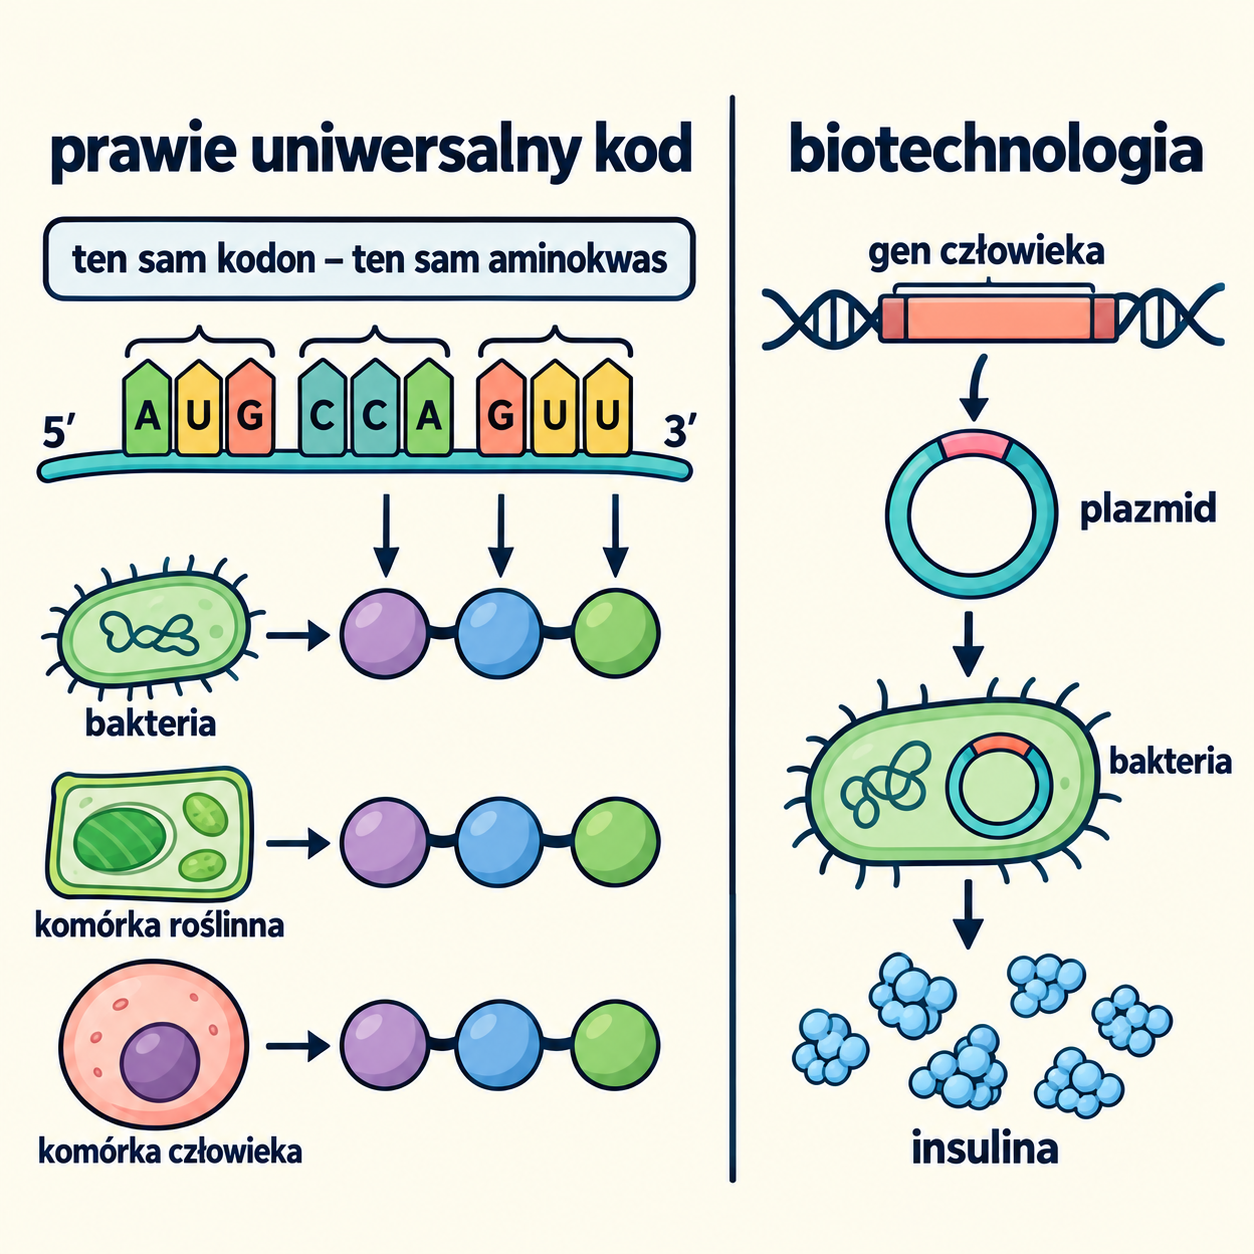
Te same kodony oznaczają zazwyczaj te same aminokwasy u niemal wszystkich organizmów.
Przykładowo kodon UUU koduje fenyloalaninę zarówno u bakterii, roślin, grzybów, jak i zwierząt. Uniwersalność kodu genetycznego jest jednym z argumentów przemawiających za wspólnym pochodzeniem organizmów żywych.
Kod określa się jednak jako prawie uniwersalny, ponieważ istnieją nieliczne wyjątki. Odmienności występują między innymi:
- w genomach mitochondrialnych,
- u niektórych protistów,
- u części mikroorganizmów.
Przykładowo w ludzkich mitochondriach kodon UGA może oznaczać tryptofan, chociaż w standardowym kodzie genetycznym jest kodonem STOP.
Kod genetyczny jest kolinearny
Kolejność kodonów w mRNA odpowiada kolejności aminokwasów w powstającym łańcuchu polipeptydowym.
Jeżeli pierwszy odczytany kodon oznacza metioninę, drugi alaninę, a trzeci lizynę, aminokwasy zostaną połączone właśnie w takiej kolejności.
Sekwencja nukleotydów:
5′–AUG–GCU–AAA–3′
odpowiada więc sekwencji:
metionina – alanina – lizyna
Czym jest ramka odczytu?
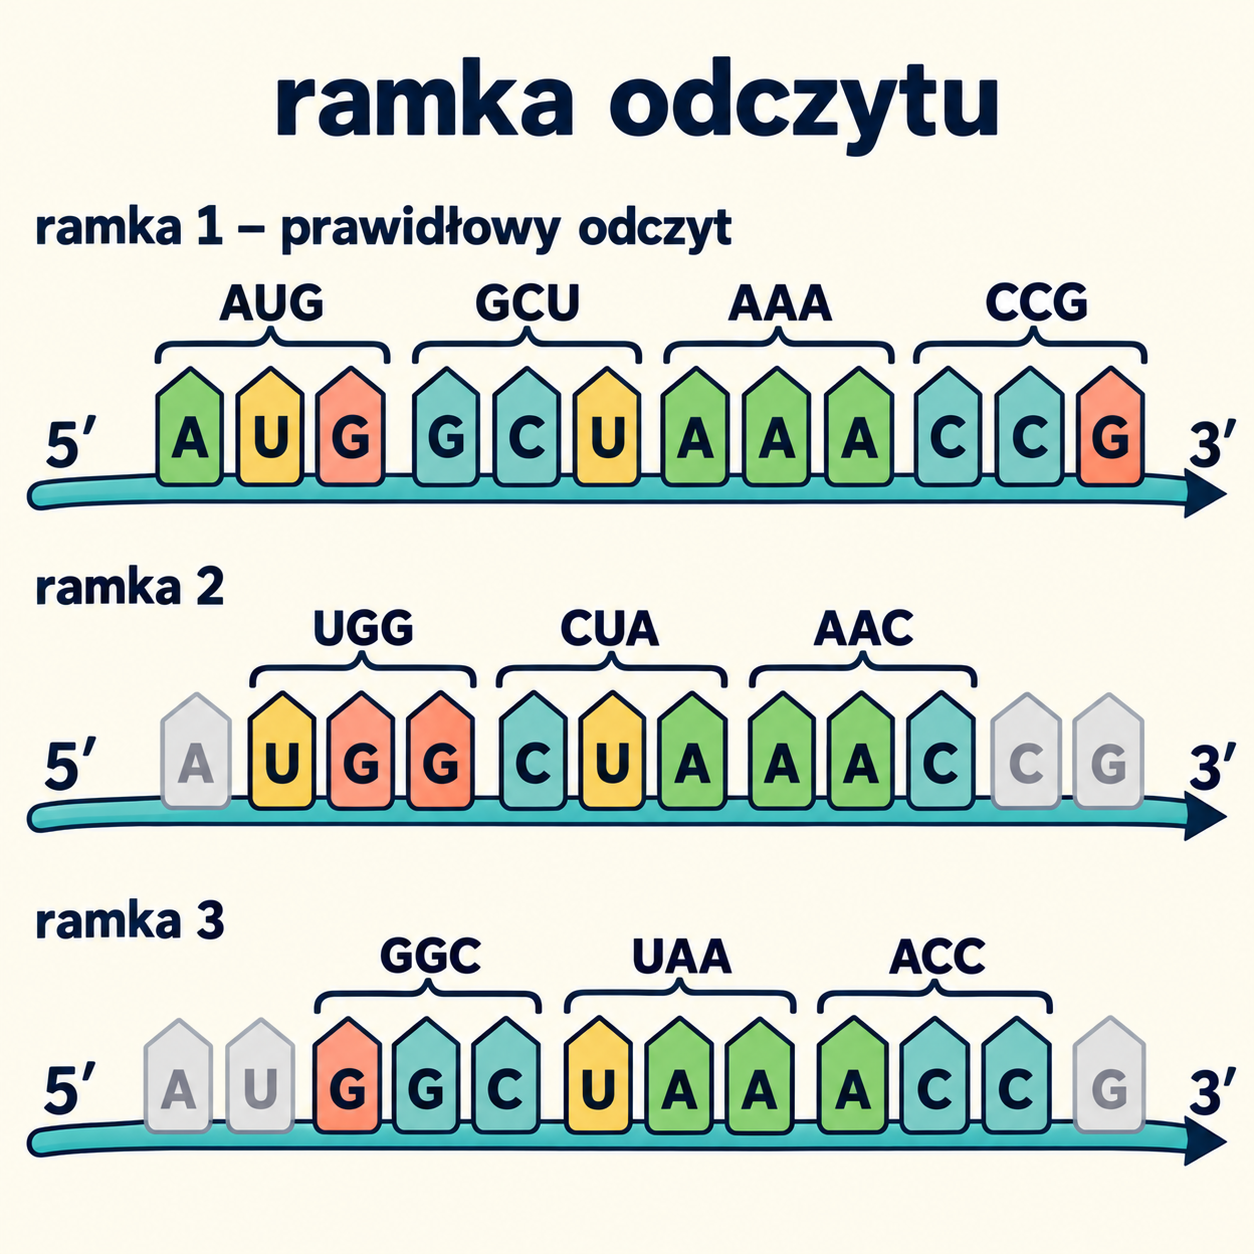
Ramka odczytu określa sposób podziału sekwencji nukleotydów na kolejne kodony.
Dla sekwencji:
AUGGCUAAACCG
możliwe są różne sposoby podziału:
- AUG | GCU | AAA | CCG,
- UGG | CUA | AAC,
- GGC | UAA | ACC.
Każda ramka prowadzi do odczytania innego zestawu kodonów, a więc może dawać inną sekwencję aminokwasów.
Podczas prawidłowej translacji ramka odczytu zostaje ustalona przez rozpoznanie właściwego kodonu START. Od tego miejsca rybosom dzieli sekwencję mRNA na kolejne trójki.
Przesunięcie ramki odczytu może całkowicie zmienić informację zapisaną w dalszej części genu.
Jak korzystać z tabeli kodu genetycznego?
Tabela kodu genetycznego przedstawia znaczenie kodonów występujących w mRNA. Odczytuje się ją zawsze dla sekwencji zapisanej w kierunku:
5′ → 3′
Jeżeli podana została sekwencja nici kodującej DNA, należy zastąpić tyminę uracylem.
Przykład:
- nić kodująca DNA: 5′–ATG–GCT–AAA–TGA–3′,
- mRNA: 5′–AUG–GCU–AAA–UGA–3′,
- białko: metionina – alanina – lizyna.
Jeżeli podano nić matrycową DNA, trzeba najpierw utworzyć komplementarną i antyrównoległą sekwencję mRNA.
Przykład:
- nić matrycowa DNA: 3′–TAC–CGA–TTT–ACT–5′,
- mRNA: 5′–AUG–GCU–AAA–UGA–3′,
- białko: metionina – alanina – lizyna.
Najczęstszy błąd polega na bezpośrednim odczytywaniu kodonów z nici matrycowej DNA. Tabela kodu genetycznego odnosi się do kodonów mRNA, a nie do tripletów nici matrycowej.
Kod genetyczny a mutacje
Zmiana sekwencji nukleotydów może prowadzić do zmiany kodonu, a w konsekwencji – do zmiany budowy białka. Efekt mutacji zależy jednak od rodzaju zmiany i miejsca jej wystąpienia.
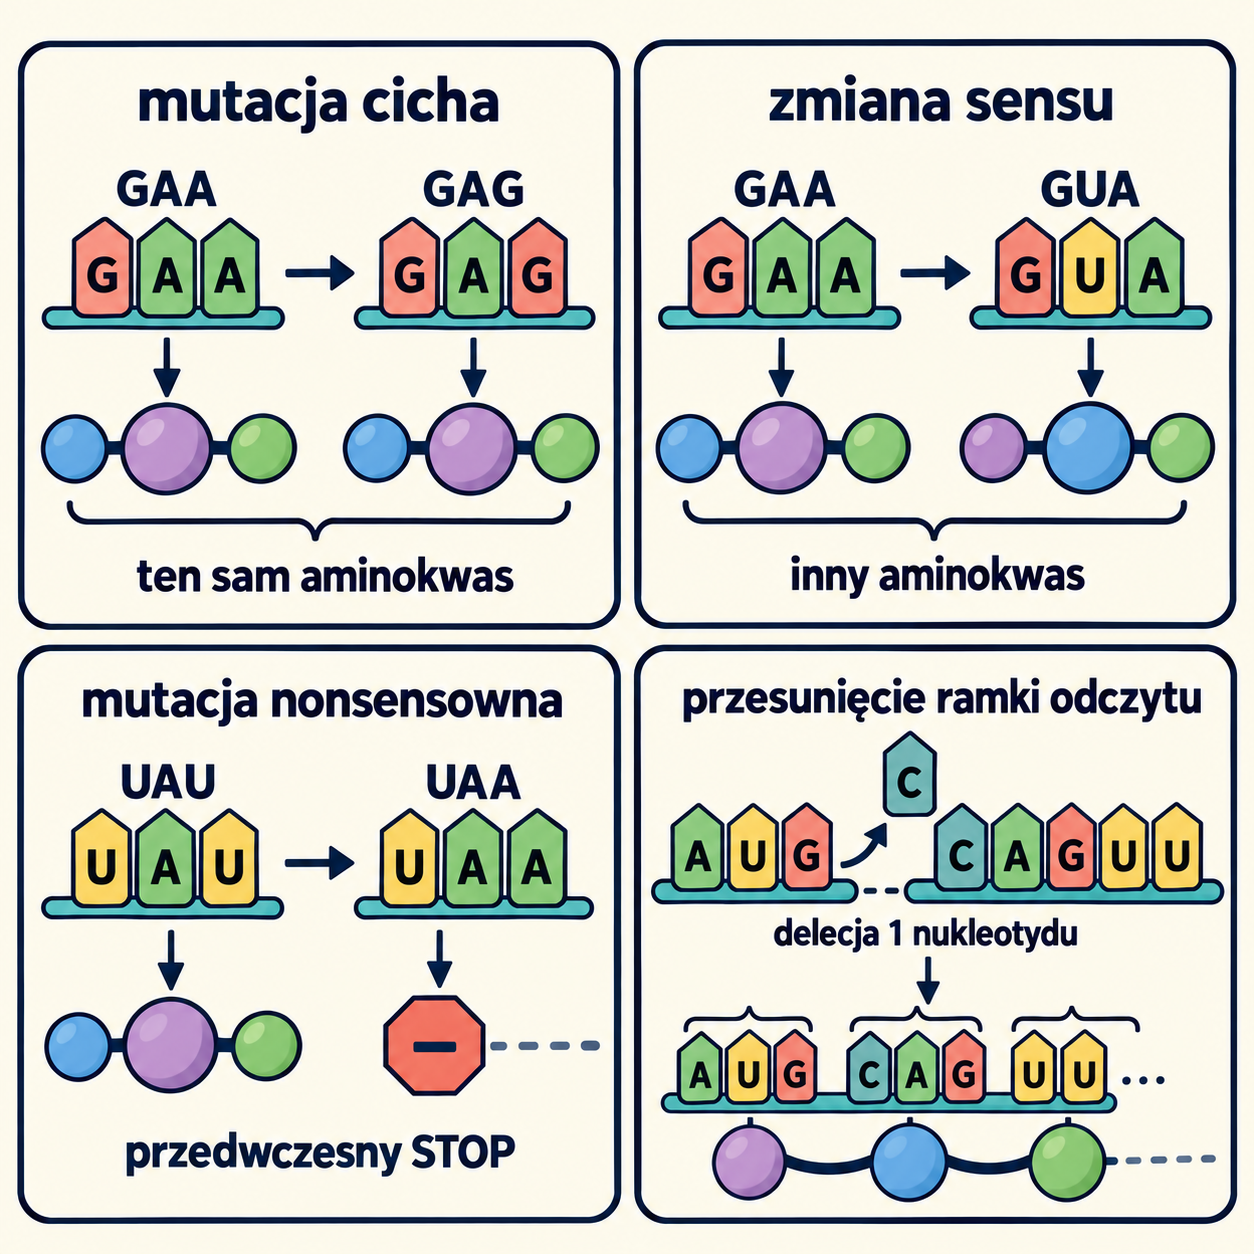
Mutacja cicha
Zmiana nukleotydu prowadzi do powstania innego kodonu, który nadal oznacza ten sam aminokwas.
Przykład:
- GAA – kwas glutaminowy,
- GAG – kwas glutaminowy.
Sekwencja aminokwasów pozostaje niezmieniona. Jest to możliwe dzięki zdegenerowaniu kodu genetycznego.
Mutacja zmiany sensu
Nowy kodon oznacza inny aminokwas.
Przykład:
- GAA – kwas glutaminowy,
- GUA – walina.
Zmiana jednego aminokwasu może nie mieć większego znaczenia albo silnie wpłynąć na budowę i funkcję białka. Zależy to od właściwości aminokwasu oraz miejsca, w którym wystąpiła zmiana.
Mutacja nonsensowna
Zmiana nukleotydu powoduje powstanie kodonu STOP.
Translacja kończy się zbyt wcześnie, dlatego powstaje skrócone białko, które najczęściej nie jest prawidłowo funkcjonalne.
Mutacja przesuwająca ramkę odczytu
Wstawienie lub usunięcie liczby nukleotydów niepodzielnej przez trzy zmienia sposób grupowania wszystkich kolejnych nukleotydów w kodony.
Przykładowo prawidłowa sekwencja:
AUG | GCU | AAA | CCG
po usunięciu jednego nukleotydu może być odczytywana jako:
AUG | CUA | AAC…
Zmianie ulegają wówczas wszystkie kodony położone za miejscem mutacji. Często pojawia się również przedwczesny kodon STOP.
Jeżeli zostaną dodane lub usunięte dokładnie trzy nukleotydy, ramka odczytu pozostaje zachowana, ale w białku pojawia się albo znika jeden aminokwas.
Jakie znaczenie ma uniwersalność kodu genetycznego?
Prawie uniwersalny charakter kodu genetycznego ma znaczenie zarówno ewolucyjne, jak i praktyczne.
Dowód wspólnego pochodzenia organizmów
Fakt, że bakterie, rośliny i zwierzęta korzystają niemal z tego samego sposobu zapisu informacji, wskazuje na ich wspólne pochodzenie ewolucyjne.
Kod genetyczny musiał powstać bardzo wcześnie w historii życia i zostać zachowany w kolejnych liniach ewolucyjnych.
Podstawa inżynierii genetycznej
Uniwersalność kodu sprawia, że gen pochodzący z jednego organizmu może zostać odczytany przez komórkę innego organizmu.
Przykładowo ludzki gen kodujący insulinę można wprowadzić do komórek bakteryjnych. Bakterie odczytują znajdujące się w nim kodony i produkują ludzkie białko.
Mechanizm ten wykorzystuje się między innymi do otrzymywania:
- insuliny,
- hormonu wzrostu,
- czynników krzepnięcia,
- enzymów,
- antygenów stosowanych w szczepionkach.
Samo wprowadzenie genu nie zawsze wystarcza. Komórki różnych organizmów mogą preferować odmienne kodony oznaczające ten sam aminokwas, a komórki bakteryjne nie przeprowadzają typowej dla eukariontów obróbki pre-mRNA. Dlatego w biotechnologii często wykorzystuje się DNA pozbawione intronów i odpowiednio optymalizuje sekwencję kodonów.
Czy jeden gen zawsze koduje jedno białko?
Proste stwierdzenie „jeden gen – jedno białko” nie opisuje wszystkich możliwości komórki eukariotycznej.
Jedna sekwencja pre-mRNA może być poddawana alternatywnemu splicingowi. W zależności od tego, które eksony zostaną połączone, z jednego genu mogą powstać różne cząsteczki mRNA, a następnie różne warianty białka.
Nie zmienia to zasad kodu genetycznego. Każdy kodon nadal oznacza ten sam aminokwas, ale zmienia się zestaw kodonów obecnych w dojrzałym mRNA.
Kod genetyczny krok po kroku
Aby na podstawie sekwencji DNA ustalić sekwencję aminokwasów:
- Sprawdź, czy podano nić kodującą, czy nić matrycową DNA.
- Zapisz sekwencję mRNA w kierunku 5′ → 3′.
- W przypadku nici kodującej zastąp T przez U.
- W przypadku nici matrycowej utwórz sekwencję komplementarną i antyrównoległą.
- Znajdź kodon START – najczęściej AUG.
- Podziel sekwencję od kodonu START na kolejne trójki.
- Odczytaj znaczenie każdego kodonu z tabeli kodu genetycznego.
- Zakończ odczytywanie po napotkaniu kodonu STOP.
- Zapisz aminokwasy w kolejności wynikającej z układu kodonów.
Podsumowanie
Kod genetyczny jest zestawem reguł umożliwiających przetłumaczenie sekwencji nukleotydów mRNA na sekwencję aminokwasów w białku.
Jego podstawową jednostką jest kodon, czyli trójka nukleotydów. Kod genetyczny jest:
- trójkowy,
- jednoznaczny,
- zdegenerowany,
- bezprzecinkowy,
- niezachodzący,
- kolinearny,
- prawie uniwersalny.
Translacja rozpoczyna się zazwyczaj od kodonu AUG, natomiast kodony UAA, UAG i UGA wyznaczają jej zakończenie. Prawidłowe ustalenie ramki odczytu ma kluczowe znaczenie, ponieważ przesunięcie jej nawet o jeden nukleotyd zmienia sposób odczytywania całej dalszej sekwencji.
Prawie uniwersalny charakter kodu genetycznego łączy wszystkie organizmy żywe i stanowi podstawę nowoczesnej biotechnologii.
Sprawdź, czy już potrafisz
- Wyjaśnij, czym jest kod genetyczny.
- Zdefiniuj pojęcie kodonu.
- Dlaczego kod genetyczny musi być co najmniej trójkowy?
- Ile istnieje wszystkich możliwych kodonów?
- Ile kodonów koduje aminokwasy?
- Jaką funkcję pełni kodon AUG?
- Wymień trzy kodony STOP.
- Wyjaśnij, na czym polega jednoznaczność kodu genetycznego.
- Wyjaśnij, na czym polega zdegenerowanie kodu genetycznego.
- Dlaczego kod genetyczny określa się jako prawie uniwersalny?
- Co oznacza, że kod genetyczny jest bezprzecinkowy?
- Co oznacza, że kod genetyczny jest niezachodzący?
- Na czym polega kolinearność kodu genetycznego?
- W jakim kierunku rybosom odczytuje mRNA?
- Jakie funkcje pełnią tRNA i antykodon?
- Czym jest ramka odczytu?
- Dlaczego delecja jednego nukleotydu może mieć poważniejsze skutki niż delecja trzech nukleotydów?
- Czym różni się mutacja cicha od mutacji zmiany sensu?
- Na czym polega mutacja nonsensowna?
- Jak uniwersalność kodu genetycznego wykorzystuje się w biotechnologii?
CZYTAJ DALEJ
Powiązane artykuły
POTRZEBUJESZ WSPARCIA?
Nie uczę zapamiętywać biologii i chemii. Uczę je rozumieć.
Podczas indywidualnych zajęć możemy spokojnie uporządkować ten temat i przećwiczyć go na zadaniach.
Zobacz korepetycje